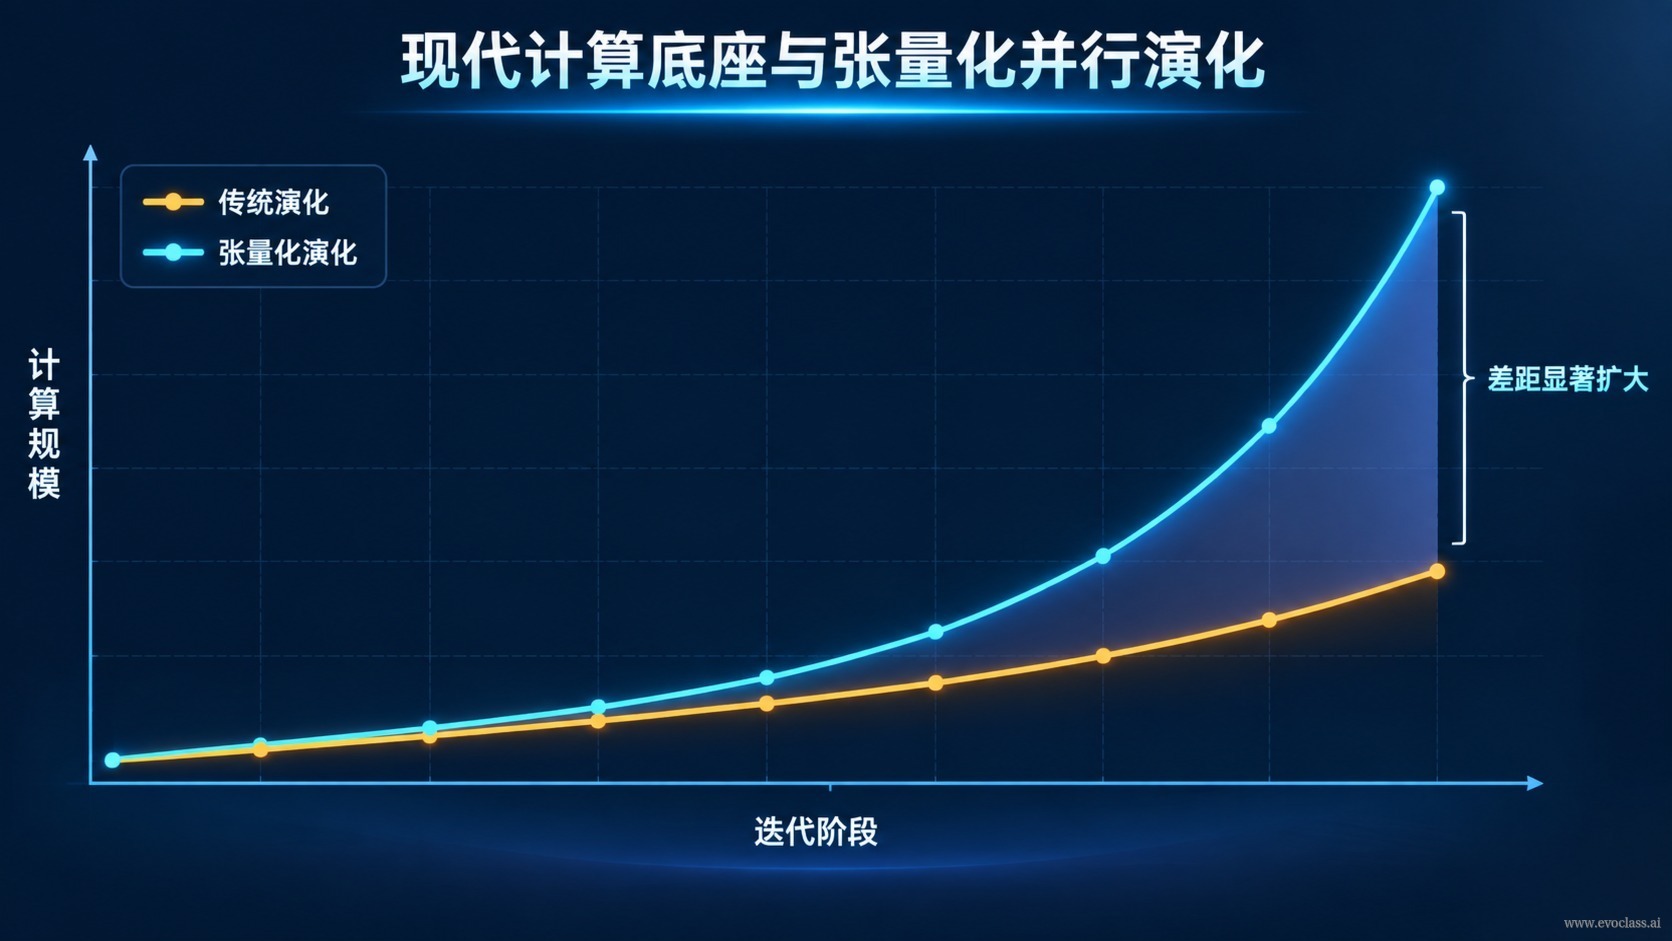
A computação evolutiva moderna enfrenta um conflito estrutural:a eficácia da evolução depende da diversidade da população, e a diversidade se converte diretamente em número de avaliações, gestão de estado e custos de agendamento; a abordagem tradicional de executar cada indivíduo em loops na CPU atinge rapidamente o teto de throughput. A resposta da infraestrutura computacional moderna é reorganizar população, avaliação e estado emtensorescalculáveis de forma integral, substituindo o loop por indivíduo porparalelismo em lotena GPU, avançando simultaneamente um grande número de candidatos na mesma rodada.
Por que o loop serial atinge o teto primeiro
Em uma implementação serial, cada iteração exige chamar a função objetivo individualmente para cada indivíduo, atualizar o estado individualmente e registrar logs individualmente. Quando o tamanho da população cresce de algumas dezenas para milhares, o número de avaliações cresce linearmente com o tamanho, e o tempo de relógio de parede cresce quase na mesma proporção; assim que uma única simulação (por exemplo, cálculo aerodinâmico de alta precisão) se torna custosa, o throughput geral fica travado no “ritmo de núcleo único”. Quanto maior a diversidade e mais caras as avaliações, mais evidente se torna o gargalo serial.
Tensorização: organizar população, avaliação e estado como tensores
- Tensor de população: empilha os parâmetros de todos os candidatos em um tensor bidimensional (número de indivíduos × dimensões), de modo que uma única chamada de operador conclui a mutação e a atualização de toda a população, em vez de iterar um por um.
- Tensor de avaliação: agrupa e despacha requisições de avaliação em lote, executadas em paralelo pela GPU ou por serviços de processamento em lote, e depois consolida os valores retornados.
- Tensor de estado: mantém estados intermediários como fitness, violações de restrições e rankings na forma de tensores, permitindo que seleção, ordenação e atualização sejam calculadas de forma integral.
- paralelismo em lote: os três pontos acima, juntos, formam o termo central desta página — o paralelismo em lote. Ele transforma a “carga computacional trazida pela diversidade” de um fardo em uma escala absorvível pelo throughput, portanto não é um detalhe de otimização, mas uma questão de infraestrutura da computação evolutiva moderna.
Os grandes modelos levam a geração de candidatos a novas fronteiras
Quando a escala computacional se abre, a questão central deixa de ser “se é possível calcular” e passa a ser “de onde vêm os candidatos”. Os grandes modelos conseguem compreender linguagem natural, código, conhecimento de domínio e contexto do projeto, e a partir disso construir candidatos de estrutura complexa, expandindo o objeto da evolução de um conjunto de parâmetros numéricos para programas, algoritmos e até estados completos de sistemas. Formas de codificação e mutação que antes dependiam de design manual passam a poder ser geradas com participação do modelo. Duas forças se encontram: a GPU permite que um grande número de possibilidades seja explorado simultaneamente, o grande modelo faz o sistema gerar possibilidades mais ricas, e o mecanismo evolutivo envia os candidatos a tarefas reais, decidindo por meio de execução e avaliação quais mudanças merecem ser preservadas.
Um trade-off arquitetural em nível de sistema
Para engenheiros de algoritmos e desenvolvedores de sistemas, as mudanças acima não representam uma otimização local, mas um trade-off arquitetural: é preciso fazer uma ponderação em nível de sistema entre a riqueza da geração de candidatos, o throughput do cálculo em lote e a complexidade de engenharia. A diversidade é a premissa da eficácia evolutiva, mas precisa ser absorvida pelo throughput.
Comparação entre serial e paralelismo tensorizadoGráfico de linhas que compara a escala computacional da evolução serial tradicional com o paralelismo em lote tensorizado: quando a CPU tradicional avalia indivíduo por indivíduo, o número de avaliações e o tempo de relógio de parede crescem quase linearmente com o tamanho da população, atingindo o teto logo que surge uma simulação custosa; a tensorização organiza população, avaliação e estado como tensores, avançando um grande número de candidatos na mesma rodada na GPU, o que torna a diversidade e a exploração em larga escala viáveis ao mesmo tempo. Os grandes modelos, por sua vez, ampliam ainda mais as fronteiras da geração de candidatos.